
Cómo usar el Flujo de Trabajo Semántico para organizar la información de su tienda, vender más y depender menos de los anuncios.
Si usted sigue la evolución de la web, ya habrá percibido que todo el ecosistema de las búsquedas ha sufrido un sacudón considerable en los últimos años. Antes, encontrar una respuesta en un buscador significaba teclear términos en el orden correcto y recibir una lista con diez enlaces azules en una página de resultados (nuestra vieja conocida SERP, sigla de Search Engine Results Page). Le correspondía a usted, como usuario, hacer clic en cada enlace, cribar el texto y cruzar los dedos para encontrar lo que buscaba.
Ese modelo se derrumbó.
Hoy, los motores de búsqueda y los modelos de lenguaje de gran escala ya no operan por la simple correspondencia sintáctica entre cadenas de letras y caracteres. Y aquí debemos ser directos: la clásica obsesión por las “palabras clave” se ha convertido en una ilusión obsoleta. Insistir en repetir términos sueltos en las páginas con la esperanza de engañar a un algoritmo es ignorar cómo la tecnología procesa realmente el lenguaje natural; incluso las estrategias más sofisticadas, pero que aún se basan en keywords, funcionan cada vez menos. Los mecanismos modernos no buscan strings; buscan entidades, conceptos y significados.
Por eso, mi definición de SEO es optimización para mecanismos de búsqueda y generación de información. Prefiero ir más allá de las fórmulas de manual y adoptar una visión estratégica, de naturaleza teórica y práctica, dedicada a estructurar el contenido de un proyecto para que los sistemas inteligentes comprendan lo que representa, puedan indexar sus páginas con precisión y organicen ese conocimiento en respuesta a las necesidades reales de las personas.
El SEO semántico es el proceso de construir significados y alinear conceptos en la web. En lugar de perseguir términos aislados, modelamos el conocimiento, eliminamos ambigüedades y conectamos los datos de nuestra tienda a una red semántica comprensible tanto para seres humanos como para algoritmos y modelos de lenguaje de gran escala. Y, en el comercio electrónico, este enfoque no es solo un diferencial técnico: se convierte en una cuestión de supervivencia financiera.
El papel del SEO en el e-commerce, la trampa del tráfico de pago y el valor de la búsqueda orgánica
Quien gestiona una tienda online en Brasil conoce de cerca la realidad de los números. En los últimos años, el coste de adquisición de clientes (CAC) en las plataformas de anuncios se ha disparado. Los e-commerces pequeños y medianos han visto cómo sus márgenes de beneficio eran devorados por subastas de medios de pago cada vez más caras e imprevisibles.
Vivir exclusivamente del tráfico de pago es alquilar su propia audiencia. Y en el instante en que se pausa el presupuesto de anuncios, las ventas se desploman de inmediato; usted lo sabe. Para sobrevivir en esta rueda de hámster estresante, necesita vender para facturar, pero también necesita entregar una porción desproporcionada de la facturación a las plataformas de anuncios solo para mantener las visitas.
Es en este escenario donde la búsqueda orgánica se consolida como el activo más valioso de una tienda online. El tráfico orgánico no cobra peaje por cada clic; es acumulativo: cuando usted construye una arquitectura de información consistente, cada producto, categoría y contenido indexado pasa a trabajar para su negocio de forma continua, día tras día.
Sin embargo, para cosechar los frutos del tráfico orgánico en un mercado saturado, no sirve de nada dar de alta productos con prisas, copiando y pegando los textos estandarizados enviados por los proveedores. Es indispensable tratar su catálogo con rigor informacional. Ahí es donde entra la metodología que desarrollé: el FTS.
¿Qué es el FTS (flujo de trabajo semántico)?
El Flujo de Trabajo Semántico es una metodología que sistematicé en mi libro SEO Semántico: Flujo de trabajo semántico en 2022. La propuesta central del FTS es rescatar el arsenal teórico y los artefactos milenarios de la Biblioteconomía y la Ciencia de la Información —como vocabularios controlados, taxonomías, tesauros y esquemas de clasificación— y aplicarlos directamente a la arquitectura y optimización de entornos digitales.
Durante mis estudios en la carrera de Biblioteconomía en la UFRGS, percibí con mucha claridad que los mayores dilemas a los que nos enfrentamos en el SEO moderno —como problemas de ambigüedad, ruido en la recuperación de documentos, canibalización de URL y falta de contexto temático— ya han sido ampliamente estudiados y resueltos por las disciplinas de organización de la información desde hace décadas.
En proyectos corporativos y editoriales habituales, el FTS empieza por lo que llamamos Modelado de Dominio, donde estudiamos la literatura científica del área, reunimos un conjunto de textos sobre el tema (lo que la lingüística llama corpus) y construimos la taxonomía desde cero. Sin embargo, cuando llegamos al universo de las tiendas online, la lógica exige una adaptación metodológica más precisa y especializada. El catálogo de un e-commerce tiene características propias que requieren un camino a medida.
La bifurcación del FTS: por qué el e-commerce empieza con Dublin Core y no con el modelado abierto de dominio
En el diagrama metodológico del FTS, establezco una bifurcación que nos separa del resto del mercado ya en el primer paso: ¿el proyecto es un e-commerce? ¿Sí o no?
En un sitio institucional o un blog temático, el dominio del conocimiento suele ser amplio y conceptual (como Filosofía, Derecho Civil o Medicina Preventiva). El analista necesita identificar conceptos abstractos, analizar documentos y delimitar fronteras teóricas. En el comercio electrónico, en cambio, trabajamos con objetos informacionales estructurados por definición: los productos.
Un producto no es un ensayo teórico abierto; es un ítem tangible dotado de atributos objetivos (nombre, modelo, fabricante, talla, voltaje, precio, disponibilidad). Por eso, en el e-commerce, el FTS no se inicia con la recopilación abierta de corpora bibliográficos, sino con la adopción directa de un estándar consagrado de metadatos: el Dublin Core.
Para quien no es del área de la Ciencia de la Información, ¿qué es Dublin Core?
El DC es una iniciativa internacional de estandarización (mantenida por la Dublin Core Metadata Initiative – DCMI) creada para describir recursos digitales en la web mediante un vocabulario simple e interoperable. En lugar de inventar términos de nuestra propia cosecha, Dublin Core proporciona quince propiedades básicas universales:
Contenido (Elementos descriptivos)
- Title (Título): El nombre dado al recurso.
- Subject (Asunto): El tema del contenido del recurso (generalmente expresado mediante códigos de clasificación).
- Description (Descripción): Una explicación del contenido del recurso (como resúmenes, sumarios o descripciones textuales).
- Source (Fuente): Una referencia a un recurso del cual se deriva el recurso actual (un libro original del que se escaneó la página, por ejemplo).
- Language (Idioma): El idioma del contenido intelectual del recurso.
- Relation (Relación): Una referencia a un recurso relacionado (como “es parte de”, “es una versión de”).
- Coverage (Cobertura): El alcance espacial (lugar) o temporal (periodo de tiempo) del contenido del recurso.
Propiedad intelectual (Elementos de autoría)
- Creator (Creador): La entidad (persona, organización o servicio) responsable principalmente de crear el contenido del recurso.
- Contributor (Colaborador): Una entidad responsable de realizar contribuciones al contenido del recurso (como editores o ilustradores).
- Publisher (Editor): La entidad responsable de poner el recurso a disposición.
- Rights (Derechos): Información sobre los derechos de autor y de propiedad retenidos sobre el recurso.
Instanciación (Elementos físicos/digitales)
- Date (Fecha): Una fecha asociada a un evento en el ciclo de vida del recurso (generalmente la fecha de creación o publicación).
- Type (Tipo): La naturaleza o género del contenido del recurso (como texto, imagen, software o sonido).
- Format (Formato): La manifestación física o digital del recurso (como el formato del archivo, el medio o las dimensiones).
- Identifier (Identificador): Una referencia inequívoca al recurso dentro de un contexto específico (como una URL, DOI o ISBN).
Dublin Core ampliado (Terms)
Aunque los 15 elementos originales siguen siendo el núcleo (“Dublin Core Simple”), la iniciativa evolucionó hacia Dublin Core Metadata Terms (DCMT o “Dublin Core Qualified”). Esta versión ampliada añadió más de 55 nuevos términos y propiedades para refinar la descripción, permitiendo mayor precisión para la Web Semántica. Ejemplos de refinamientos actuales incluyen:
- audience (público objetivo)
- alternative (título alternativo)
- abstract (resumen)
- created (fecha de creación específica)
- license (licencia jurídica del recurso)
El uso de Dublin Core en el e-commerce no es la primera elección para la visualización de productos, pero desempeña un papel estratégico entre bastidores de la indexación, el SEO técnico y la interoperabilidad de datos. En el FTS integramos ambos en una estrategia combinada que permite optimizar el rendimiento de la búsqueda externa e interna. Ya sea en Google o en su sitio, su cliente encontrará el producto que quiere.
Mientras que la mayoría de las tiendas online se centra en Schema.org para generar Rich Snippets (precio, valoraciones y stock en Google), el DC se utiliza ampliamente para gestionar el acervo digital, alimentar canales de venta (marketplaces) y optimizar la búsqueda interna. A continuación puede ver los principales usos de Dublin Core y una tabla comparativa de cómo mapeamos los elementos de Dublin Core al escenario del comercio electrónico:
Ejemplo de cómo usar Dublin Core para el e-commerce
| Elemento DC | Aplicación en el e-commerce | Ejemplo práctico |
|---|---|---|
dc:title | Nombre comercial del producto. | “Smartphone Samsung Galaxy S24 Ultra 512GB” |
dc:identifier | Códigos de identificación universal y control. | SKU, código de barras (EAN/GTIN), ASIN o ISBN. |
dc:description | Descripción técnica o de marketing del producto. | Detalle de funcionalidades, especificaciones y beneficios. |
dc:creator
/
publisher | Fabricante, marca o el propio comerciante. | “Apple”, “Nike”, “Lojas Americanas”. |
dc:type | Categoría macro del ítem en el catálogo. | “Electrónica”, “Ropa”, “Libro físico”. |
dc:format | Extensión digital o especificaciones físicas. | image/jpeg (para fotos) o dimensiones/peso para el envío. |
dc:subject | Palabras clave y etiquetas de búsqueda interna. | “smartphone”, “móvil 5g”, “cámara 200mp”. |
dc:rights | Términos de garantía, propiedad industrial o licencia. | “Garantía de 12 meses por el fabricante”. |
dc:relation | Productos relacionados o variaciones de color/talla. | “Es variación de [ID-Padre]” o “Recomendado con [ID-Accesorio]”. |
¿Cuál es la ventaja de esto para el dueño de un e-commerce mediano o pequeño?
Para la pequeña empresa, que dispone de equipos reducidos y presupuestos controlados, esta bifurcación aporta agilidad y consistencia inmediata. El comerciante no necesita perder semanas intentando entender cómo estructurar los datos de su inventario. Al adoptar la lógica de Dublin Core como cimiento descriptivo, el catálogo gana un estándar aceptado internacionalmente que organiza todo el alta de stock, elimina el desorden informacional y prepara la tienda para dialogar con cualquier sistema externo sin retrabajo.
Atributos por producto: transformando el stock en metadatos sin ambigüedad
Una de las grandes lecciones que la Biblioteconomía nos enseña es la diferencia entre un mero listado de inventario y la catalogación: como su nombre indica, la actividad de crear catálogos. Como bien destacan especialistas del área, un inventario solo registra mecánicamente que un ítem existe en una estantería; la catalogación, en cambio, analiza las propiedades intrínsecas de ese objeto para individualizarlo y, al mismo tiempo, reunirlo con los demás ítems por sus semejanzas conceptuales.
Cuando aplicamos los atributos de Dublin Core directamente a cada producto del catálogo, transformamos datos brutos de stock en metadatos organizados. Un metadato no es más que “un dato sobre otro dato”: una información estructurada que describe el producto. Cuando damos de alta un ítem en nuestra tienda, necesitamos proporcionar definiciones sin ambigüedad para cada una de sus propiedades:
- Identificador (identifier): No basta con tener un código interno de control; es indispensable usar identificadores globales estandarizados, como el GTIN/EAN (código de barras) y el SKU del fabricante.
- Creador (creator) y marca: Especificar formalmente la entidad (marca) responsable de la creación del bien.
- Descripción (description): En lugar de reproducir la descripción genérica enviada por el fabricante (que cientos de competidores copian), redactar una caracterización semántica que señale la finalidad práctica de ese producto y sus diferenciales.
- Propiedades físicas y técnicas (format y dimensiones): Material, peso, dimensiones, voltaje y compatibilidad expresados en campos estandarizados, no arrojados en medio de un bloque corrido de texto.
¿Cuál es la ventaja de esto para el dueño de un e-commerce mediano o pequeño?
La mayoría de las pequeñas tiendas pierde visibilidad en Google precisamente porque replica descripciones listas de distribuidores, generando contenido duplicado y páginas sin ganancia de información. Al tratar los atributos como metadatos sin ambigüedad, la tienda destaca de inmediato. Cuando un consumidor busca un modelo específico, con atributos exactos (por ejemplo, “cafetera italiana 6 tazas inox inducción”), los mecanismos de búsqueda pueden identificar con precisión quirúrgica que su página tiene exactamente lo solicitado. El resultado directo es una mayor tasa de clics y tráfico con verdadera intención de compra.
Construcción del vocabulario controlado: hablar el idioma del cliente y del buscador
En la Ciencia de la Información, un vocabulario controlado es un lenguaje artificial y estandarizado, compuesto por términos seleccionados con rigor para representar conceptos y asuntos en un sistema de recuperación de información. Mientras que el lenguaje natural humano es rico, caótico y lleno de sinónimos, el vocabulario controlado organiza esa pluralidad estableciendo términos preferidos y términos no preferidos (o rechazados).
En mi libro, suelo ilustrar la necesidad imperativa de este instrumento con una situación clásica y recurrente en el e-commerce:
Imagine que un usuario accede a su tienda online de calzado, va a la caja de búsqueda interna y teclea: “zapato para correr”.
¿Qué responde la herramienta de búsqueda interna de la mayoría de las plataformas? Con una frecuencia asombrosa, la respuesta que aparece en pantalla es: “No se ha encontrado ningún producto. Por favor, repita su búsqueda.”
¿Por qué este desastre comercial ocurre todos los días? Porque el comerciante dio de alta el producto estrictamente bajo el término “zapatilla deportiva”. Como el sistema de búsqueda de la tienda opera de forma puramente sintáctica (empareja letras, no conceptos), no comprende que el usuario que escribió “zapato para correr” desea exactamente esa “zapatilla deportiva” en promoción en el stock. El cliente frustrado cierra la pestaña y compra en la competencia.
La solución que la Biblioteconomía nos aporta para resolver este fallo es el vocabulario controlado. En él, definimos formalmente relaciones de equivalencia semántica:
- Término preferido (adoptado por el sistema): Zapatillas de running
- Término no preferido / rechazado (UP – Use Para): Zapato para correr, calzado de running, zapatillas para cooper.
¿Cuál es la ventaja de esto para el dueño de un e-commerce mediano o pequeño?
El impacto en la caja de la empresa es inmediato. Al integrar un vocabulario controlado en el sistema de búsqueda y en los filtros de la tienda, la tasa de rebote en la búsqueda interna se desploma y la tasa de conversión sube. El cliente siempre encuentra lo que busca, independientemente de la variación lingüística que haya utilizado para expresar su intención. Además, externamente, cuando Google rastrea la página, la presencia de una malla conceptual rica en sinónimos y términos correlatos garantiza que el algoritmo comprenda el campo semántico completo de ese producto, atrayendo clientes por decenas de rutas de búsqueda distintas.
Taxonomía de categorías, navegación facetada y el arte de la clasificación en el catálogo
Llegamos a una de las etapas más elegantes de la organización del conocimiento: la estructuración taxonómica y el uso de la clasificación facetada.
En Biblioteconomía, una taxonomía es un modelo de ordenación sistemática que organiza conceptos en estructuras lógicas de conjuntos y subconjuntos (relaciones jerárquicas de género y especie, clase y subclase).
Un ejemplo de taxonomía:
Ropa
└── Calzado
└── Zapatillas 01
└── Zapatillas 02
Sin embargo, el comercio electrónico presenta una complejidad que la simple jerarquía en árbol no puede resolver por sí sola. Aquí entra la genialidad del bibliotecario indio Shiyali Ramamrita Ranganathan y su Teoría de la Clasificación Facetada.
Para entender qué es la clasificación facetada sin complicaciones, piense en unos grandes almacenes online. ¿Cómo están dispuestas las mercancías? No están arrojadas en una única lista vertical de productos. Están organizadas según diferentes puntos de vista o dimensiones, que llamamos facetas:
- Por función de uso (cocina, cama y baño, ropa);
- Por público objetivo (infantil, masculino, femenino);
- Por materia prima (vidrio, cerámica, inox, algodón, lino);
- Por talla y dimensión (pequeño, mediano, grande, individual, doble, queen).
Un único producto puede encontrarse de diferentes maneras, lo cual es perfecto. Cada cliente tiene, en su mente, una taxonomía personal donde está el producto que quiere. Sea cual sea esa estructura, nuestra tienda tiene la faceta adecuada para que encuentre lo que desea.
La clasificación facetada permite, entonces, mirar el mismo objeto desde múltiples perspectivas simultáneas. Cuando llevamos este principio a la arquitectura de una tienda online, damos vida a la navegación facetada: los famosos filtros laterales que permiten al consumidor combinar criterios como marca, color, talla, rango de precio y material.
Ropa (Superclase)
└── Calzado (Clase)
└── Zapatillas (Subclase)
├── Faceta: Modalidad [Running, Trail, Casual]
├── Faceta: Género [Masculino, Femenino, Unisex]
├── Faceta: Talla [38, 39, 40, 41, 42]
└── Faceta: Marca [Nike, Adidas, Asics]
¿Cuál es la ventaja de esto para el dueño de un e-commerce mediano o pequeño?
Una taxonomía facetada bien diseñada resuelve una de las peores pesadillas técnicas del SEO en tiendas online: el desperdicio del presupuesto de rastreo (crawl budget) y la generación descontrolada de URL duplicadas.
Cuando la plataforma no cuenta con una gestión inteligente de facetas, cada combinación de filtros en la que hace clic el usuario puede generar una nueva URL parametrizada en el servidor (como ?cor=azul&tamanho=40&ordem=preco). Esto crea decenas de miles de páginas vacías o redundantes para que el robot de Google las rastree, drenando la autoridad del dominio y generando canibalización de palabras. Muchas veces la responsabilidad de este error no es del dueño de la tienda, sino de la plataforma que está usando.
Si la plataforma de nuestra tienda lo permite, podemos aplicar la disciplina taxonómica y establecer qué facetas tienen demanda de búsqueda real para convertirse en categorías indexables y cuáles deben bloquearse o consolidarse mediante etiquetas canónicas, preservando la máxima autoridad de las páginas comerciales del sitio.
Enriquecimiento con Schema.org y GeoNames: cómo hacemos que el catálogo sea inteligible para las máquinas
Una cosa es construir una excelente organización interna para la mirada humana; otra es garantizar que los robots de los mecanismos de búsqueda y los agentes inteligentes puedan leer esas relaciones directamente en el código. Para que eso ocurra, conectamos nuestra taxonomía con los vocabularios globales de la Web.
Como señala la literatura de la Ciencia de la Información, las ontologías funcionan como representaciones formales del conocimiento de un dominio particular, estructuradas en un lenguaje lógico-formal legible por máquina. En el entorno web, la principal manifestación práctica de este concepto es el vocabulario Schema.org, implementado mediante la sintaxis JSON-LD (JavaScript Object Notation for Linked Data).
Al enriquecer el catálogo con datos estructurados de Schema.org, pasamos a declarar explícitamente en el código HTML que la página no es un amontonamiento cualquiera de texto, sino una entidad del tipo Product, que contiene una Offer (con precio, moneda y fecha de validez), un AggregateRating (con puntuaciones y reseñas reales de clientes) y una ruta de navegación formal (BreadcrumbList).
Además de Schema.org, el FTS prevé la conexión con bases de conocimiento geográfico, como GeoNames, una base de datos abierta que asocia lugares a identificadores únicos en la web. Si su tienda física u operación logística atiende a regiones específicas, vincular sus metadatos a URI de GeoNames elimina cualquier duda de los motores de búsqueda sobre el área geográfica de actuación de su negocio.
Considere este marcado en JSON:
{
«@context»: «https://schema.org/»,
«@type»: «Product»,
«name»: «Zapatillas de running masculinas Endurance Pro»,
«image»: «https://sualoja.com.br/imagens/tenis-endurance-pro.jpg»,
«description»: «Zapatillas desarrolladas para amortiguación en entrenamientos de larga distancia sobre asfalto.»,
«sku»: «END-PRO-41»,
«mpn»: «987654»,
«brand»: {
«@type»: «Brand»,
«name»: «RunTech»
},
«offers»: {
«@type»: «Offer»,
«url»: «https://sualoja.com.br/calcados/tenis-corrida-endurance-pro»,
«priceCurrency»: «BRL»,
«price»: «499.90»,
«priceValidUntil»: «2026-12-31»,
«itemCondition»: «https://schema.org/NewCondition»,
«availability»: «https://schema.org/InStock»
},
«aggregateRating»: {
«@type»: «AggregateRating»,
«ratingValue»: «4.8»,
«reviewCount»: «124»
}
}
¿Cuál es la ventaja de esto para el dueño de un e-commerce mediano o pequeño?
El impacto visual en las búsquedas es notable. Google indexa el trabajo generado con el Flujo de Trabajo Semántico para producir resultados mejorados, y entonces el buscador premia el listado orgánico con resultados personalizados para cada persona que busca sus productos. Su enlace deja de ser una línea de texto insulsa y pasa a incluir:
- Valoración con estrellas doradas;
- Cantidad de comentarios reales de compradores;
- Precio actualizado en reales;
- Sello de disponibilidad (“En stock”).
En la práctica, esto hace que su oferta destaque ante el consumidor en la página de búsqueda incluso antes del clic, elevando la tasa de clics (CTR) sin exigir ni un céntimo más de inversión en medios de pago. Una tienda pequeña obtiene el mismo nivel de sofisticación de visualización en la SERP que los gigantes multinacionales del retail.
Construcción del grafo de conocimiento interno para conectar productos, categorías e intenciones de compra
El paso final de la aplicación del FTS en el e-commerce es la integración de todas estas partes en un grafo de conocimiento interno.
¿Qué es un grafo de conocimiento?
En términos muy simples, piense en un grafo como una malla de conexiones. Tenemos “nodos” (que representan las entidades: productos, marcas, materiales, problemas, categorías) y tenemos “aristas” (que son las relaciones que unen esos nodos). En el comercio tradicional basado en la Web 1.0, el sitio se veía como un conjunto de archivos HTML aislados. En el SEO Semántico, el catálogo se convierte en una densa red de datos conectados; el término linked data representa este nuevo momento.
[Entidad: Zapatillas Endurance Pro]
│
├── (pertenece_a_la_categoría) ──> [Categoría: Zapatillas de running]
├── (producido_por) ──────────> [Marca: RunTech]
├── (indicado_para) ──────────> [Concepto: Fascitis plantar / Alto impacto]
├── (tiene_tecnología) ──────> [Entidad: Espuma de amortiguación X]
└── (relacionado_con) ────────> [Guía informativa: Cómo elegir sus zapatillas]
Cuando establecemos estos vínculos mediante enlaces internos contextuales, una taxonomía consistente y anotaciones semánticas (como Dublin Core y Schema.org), la tienda deja de ser solo un escaparate pasivo y se transforma en un repositorio curado de conocimiento sobre su nicho.
¿Cuál es la ventaja de esto para el dueño de un e-commerce mediano o pequeño?
Esta malla estructurada prepara su tienda online para el nuevo ecosistema de búsquedas orientado por inteligencia artificial. Podemos, entonces, usar Inteligencia Artificial para crear sistemas que generen información basada en todos estos datos contextualizados. El RAG (Generación Aumentada por Recuperación), que es una técnica de inteligencia artificial que conecta modelos de lenguaje con bases de conocimiento externas para generar respuestas más precisas y actualizadas, utiliza el trabajo generado por la aplicación del Flujo de Trabajo Semántico para identificar fuentes factuales y citar productos a los usuarios.
Cuando un sistema avanzado como este rastrea la web para responder preguntas como “¿qué calzado es el más recomendado para quien tiene dolor en el talón al correr en la cinta?”, ya no busca listas de palabras repetidas: recorre nodos y conexiones lógicas de datos interconectados, los grafos de conocimiento. Si su tienda cuenta con esta malla estructurada, las probabilidades de ser la entidad citada y recomendada por un asistente de IA aumentan de forma sustancial.
El cuello de botella práctico donde la teoría se encuentra con las plataformas reales de e-commerce
Toda esta metodología basada en Ciencia de la Información, Dublin Core, vocabularios y grafos de conocimiento es poderosa y transformadora. Sin embargo, choca con una barrera práctica insalvable: el código y la infraestructura tecnológica donde está instalada su tienda online.
No sirve de nada diseñar la taxonomía perfecta en papel o mapear los atributos ideales de cada producto si su plataforma de e-commerce es un sistema rígido que sabotea la aplicación del flujo. Para que el FTS funcione en el día a día, la plataforma debe garantizar soporte pleno a criterios técnicos basilares:
- Estructura de URL: Capacidad de generar direcciones limpias, amigables y jerárquicas, sin forzar subcarpetas innecesarias ni parámetros numéricos aleatorios que confunden al usuario y a los buscadores;
- Directrices para rastreadores: Generación de sitemaps XML actualizados automáticamente y control granular del archivo robots.txt;
- Autonomía editorial: Control absoluto de títulos (Meta Title) y resúmenes (Meta Description) en categorías y productos, sin depender del nombre técnico del software de gestión (ERP);
- Control de canonicidad: Aplicación correcta de etiquetas canónicas (rel=»canonical») para proteger la tienda frente a la duplicación en variaciones de color y talla;
- Datos estructurados nativos: Soporte para datos Schema en JSON-LD sin romper el diseño;
- Velocidad móvil y Core Web Vitals: Carga ágil en el móvil, sin sobrecarga de scripts pesados;
- Gestión de redirecciones 301: Flexibilidad para cambiar enlaces o descatalogar productos sin generar pantallas de error 404.
En el mercado brasileño orientado a pequeñas y medianas empresas, vemos disparidades técnicas marcadas entre los sistemas más populares:
- WooCommerce: Ofrece libertad técnica absoluta para personalizar URL, taxonomías, sitemaps y esquemas de datos, pero exige servidor dedicado y mantenimiento técnico constante;
- Nuvemshop: Destaca por la agilidad de configuración, excelente adaptación al ecosistema de pagos y envíos locales y buena velocidad móvil, siendo muy amigable para la operación de pymes;
- Shopify: Plataforma robusta y estable a nivel global, pero impone restricciones estructurales en las URL (prefijos obligatorios como /products/ y /collections/) que limitan la libertad taxonómica;
- Tray Commerce: Muy fuerte en la integración nativa con marketplaces y ERP nacionales, pero requiere atención cuidadosa en la gestión de parámetros de URL y facetas;
- Loja Integrada: Presenta una barrera de entrada muy baja para comerciantes principiantes; sin embargo, impone limitaciones técnicas sensibles en el control fino de metadatos avanzados, etiquetas canónicas y datos estructurados complejos.
La elección de la tecnología, por tanto, no es solo una decisión de diseño o de coste mensual: define el techo de su rendimiento orgánico.
Conozca el SEO para e-commerce
Organizar la información de su tienda online no es un capricho académico ni un lujo restringido a los gigantes del retail con presupuestos millonarios. Al contrario.
Para el dueño de un e-commerce mediano o pequeño, el SEO semántico y la aplicación del FTS representan la estrategia más inteligente y sostenible para romper la dependencia del tráfico de pago, poner en valor cada visita recibida y construir un negocio rentable a largo plazo.
Cuando sustituimos la ilusión de las palabras clave por una arquitectura consistente de conceptos, atributos sin ambigüedad, vocabularios controlados y datos estructurados, situamos nuestra tienda online al mismo nivel de sofisticación que los mayores portales de la web. Su catálogo pasa a ser comprendido con claridad por Google y por agentes inteligentes, convirtiendo a muchos más clientes en la búsqueda interna y atrayendo compradores decididos en la búsqueda externa.
¿Quiere descubrir exactamente cómo se comporta su plataforma actual ante estos requisitos técnicos y qué necesita ajustarse en su tienda para desbloquear su tráfico orgánico?
Le invito a conocer el SEO para Commerce.
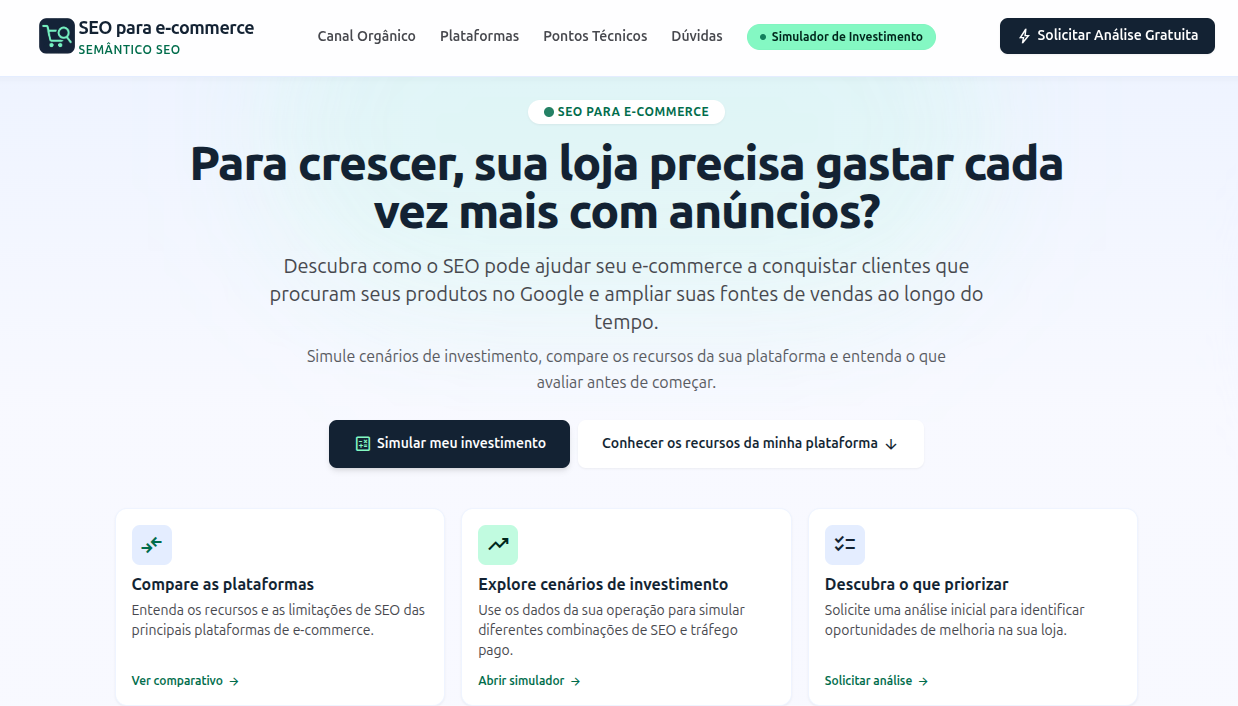
En esta página, analizamos en detalle los 8 criterios técnicos esenciales para el rendimiento orgánico de tiendas online, comparamos las principales plataformas del mercado nacional y le ofrecemos una oportunidad exclusiva para solicitar un análisis gratuito de su tienda online. Acceda, consulte la matriz comparativa y dé el primer paso para transformar el catálogo de su e-commerce en un verdadero activo estratégico de ventas.